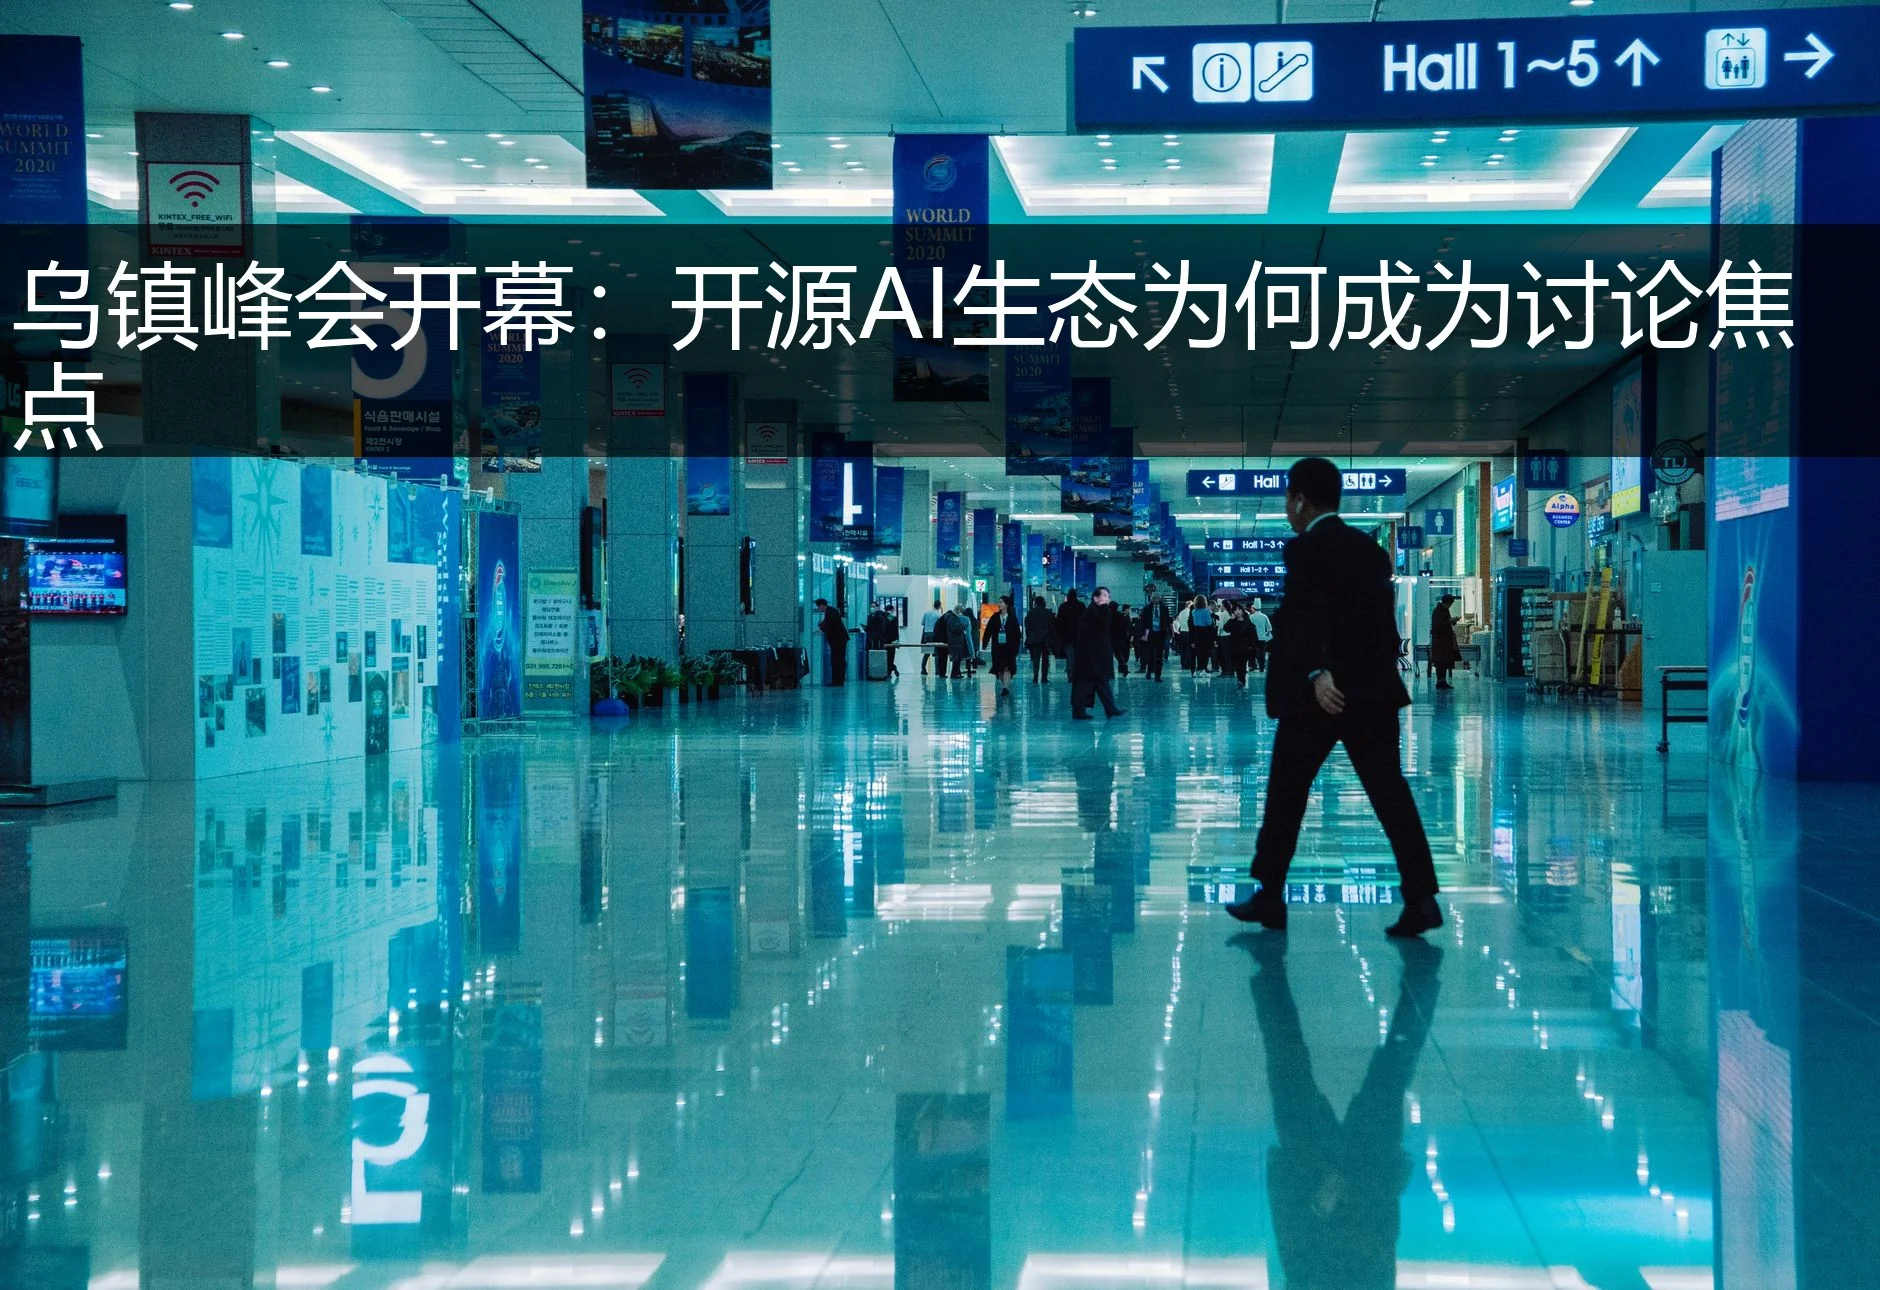
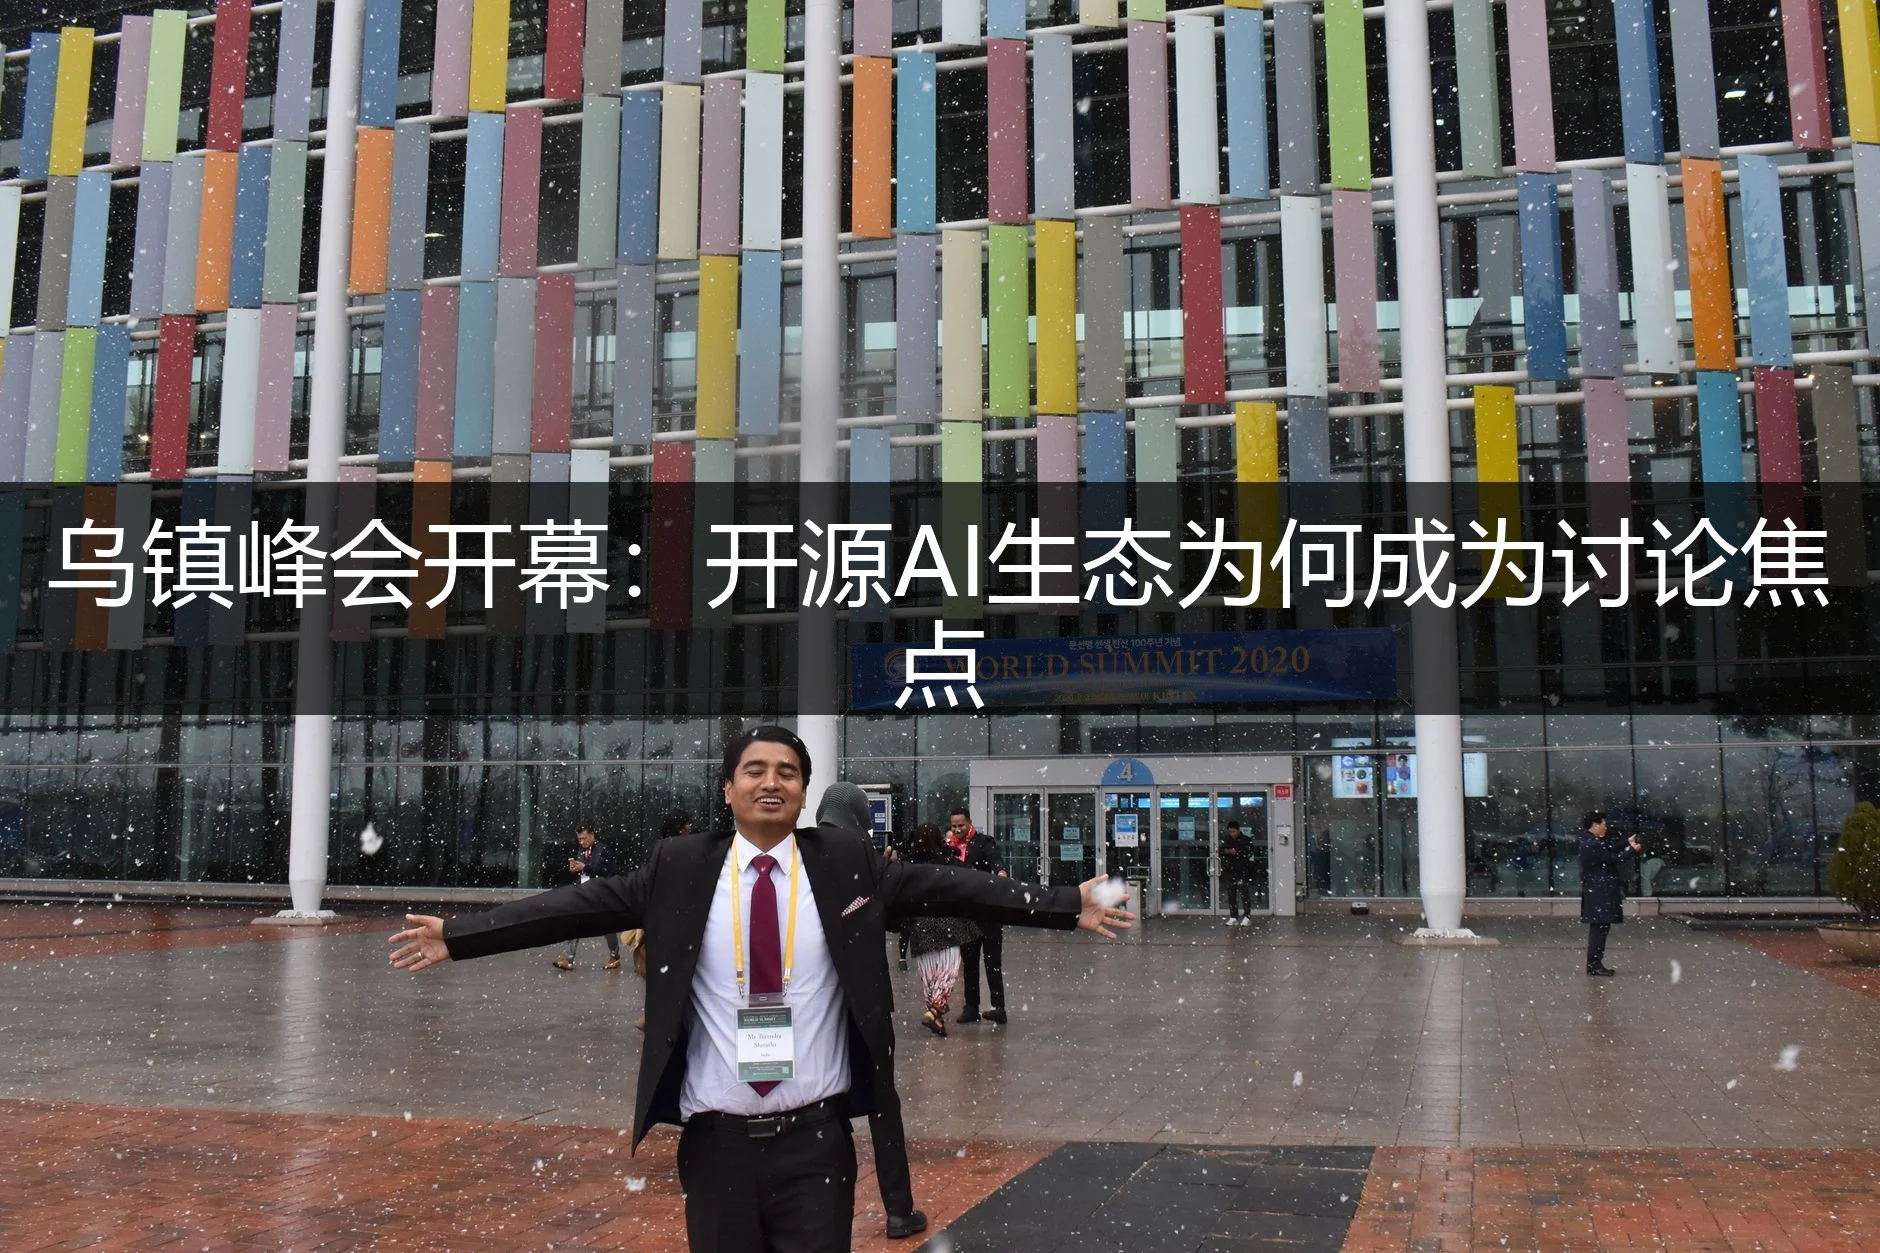
2026年世界互联网大会乌镇峰会于11月3日开幕,围绕人工智能开源生态的讨论在会场内外持续展开。中新社报道以“中国开源AI大模型持续圈粉”为观察角度,将开源模型与开发者生态置于峰会话题的中心位置。对关注AI产业的人来说,这一议题的价值不只在于一场会议的议程设置,更在于它把“模型是否开放、开放到什么程度、开放之后如何形成生态”这些问题摆到了台面上。
需要区分的是,峰会开幕与开源AI成为讨论热点是已确认的事实;而开源生态究竟能在多大范围内降低AI应用门槛、形成怎样的商业回报,仍取决于许可条款、工程能力和产业协作等条件。以下从机制、影响与风险几个层面展开分析,帮助读者判断这一议题的实际分量。
开源AI为什么会被放到峰会主议题的位置
AI产业的竞争重心正在从单一模型能力转向应用落地,而应用落地依赖大量开发者、行业方案商和中小企业的参与。开源模型的意义在于,它把模型权重、训练方法或工具链以可获取的方式交到更多团队手中,使企业可以在自己的数据与场景中做二次开发和部署。相比完全依赖外部闭源服务,开源路径让使用者对成本结构、数据流向和技术路线拥有更多控制权,这正是它容易获得开发者关注的原因。
从生态角度看,开源还改变了协作方式。模型发布方提供基础能力,社区贡献微调方案、评测工具和部署优化,行业用户则反馈真实场景中的问题,形成循环。乌镇峰会聚焦这一话题,反映的是产业界对“谁来提供公共技术底座、谁来承担生态运营”的关切。开源并不等于免费,也不等于无门槛,它更像一种组织产业分工的制度安排,讨论热度背后是各方对规则制定权的关注。
“圈粉”背后:开发者与行业用户各取所需
对开发者而言,开源模型提供了可研究、可修改的对象。团队能够查看模型结构、复现训练流程、针对特定任务做微调,并在自己的硬件条件下评估推理成本。这种透明度降低了学习与试验的门槛,也让技术能力较弱的中小团队有机会站在已有成果上做增量创新。对行业用户而言,可本地化部署意味着数据不必全部流出自有环境,在合规要求较高的场景中更具吸引力。
但“圈粉”能否转化为长期使用,取决于几个现实条件。其一是模型在具体任务上的效果是否稳定,其二是配套工具是否足够成熟,其三是许可协议是否清晰、商用边界是否明确。开源模型如果缺少文档、评测基准和长期维护,使用者仍会面临较高的集成成本。因此,开源生态的竞争力不只看模型参数或发布频率,更看围绕模型形成的工程服务体系是否可持续。
开源不等于低风险:许可、安全与治理的约束
开源AI的治理问题比传统软件更复杂。模型权重一旦开放,使用者可以在不受发布方直接控制的环境中运行和改造,滥用风险、输出偏差和安全防护责任如何分配,需要许可条款和技术手段共同回答。不同开源许可对商用、再分发、署名和专利授权的规定并不相同,企业在采用前需要做合规评估,而不能把“开源”简单理解为“可以随意使用”。
另一个约束是安全能力的可迁移性。发布方在模型中加入的安全对齐措施,可能在二次微调后被削弱;社区版本的分发链条较长,问题追溯也更困难。这意味着开源生态需要配套的评测规范、漏洞披露机制和使用者教育。峰会层面的讨论如果能够推动这些基础性规则的形成,其价值将超过单纯展示模型能力;如果只停留在发布数量和应用案例层面,生态的长期健康度仍待观察。
对产业格局的潜在影响与边界
开源模型的扩散可能改变AI产业的议价结构。当基础能力可以通过开放权重获取时,价值会更多向数据治理、行业知识、工程集成和运营服务转移,单纯依靠模型接口收费的空间受到压缩。这对擅长垂直场景的企业是机会,对只做通用能力分发的厂商则构成压力。与此同时,开源项目之间的竞争也会促使发布方更重视文档质量、工具链完整度和社区响应速度。
这种影响有明确边界。高复杂度任务、超大规模训练和极致性能场景,仍可能需要集中化的算力与工程投入,闭源服务在这些领域仍有优势。开源与闭源更可能形成分层共存:开源承担普及与定制,闭源承担尖端能力与托管服务。判断开源生态的实际进展,应看企业是否真的把开源模型用于生产系统,而不是只看下载量或讨论热度。
后续值得观察的三个信号
第一个信号是许可与治理规则是否更清晰。开源AI要进入更多行业,商用边界、责任划分和安全要求需要可操作的共识,否则企业采用时会因不确定性而迟疑。第二个信号是工具链与服务体系是否跟上,包括部署框架、评测基准、微调工具和技术支持,这些决定了开源模型从“能用”到“好用”的距离。第三个信号是行业落地案例是否从演示走向持续运行,只有生产环境中的稳定使用,才能证明生态具备自我造血能力。
乌镇峰会开幕把开源AI生态推到了讨论前台,但生态的成熟不取决于一次会议的热度,而取决于规则、工程与商业回报能否形成闭环。对读者而言,更值得跟踪的是开源模型在具体行业中的采用深度,以及围绕它形成的协作机制是否稳定可预期。